ELK Stack 实战:Docker Compose 部署、Logstash 管道与分片调优全配置指南
搜索「ELK 部署教程」,出来的基本还是
docker run elasticsearch:7.x加一句discovery.type=single-node,Kibana 直接ELASTICSEARCH_HOSTS=http://es:9200。可如果你在 2026 年照着做,会连撞几堵墙:8.0 起安全默认开启,没有令牌 Kibana 根本连不上;9.x 全栈必须同版本,ES 9 配 Kibana 8 直接报错;vm.max_map_count没调,容器起来就退出。这篇先把版本和许可讲清楚,再给一套能直接跑起来的 Compose + 环境变量配置,然后串起采集选型、Logstash 管道、ILM 生命周期和分片/JVM 调优,最后把十个高频坑和排障对照表一次说透。命令都标明了适用场景,别照搬。
目录
- 零、先搞清楚:ELK、Elastic Stack 与 OpenSearch 是什么关系
- 一、版本与许可:2026 年动手前必读
- 二、整体架构与数据流
- 三、部署前的系统前置(这一步最容易被跳过)
- 四、Docker Compose 部署(体验版 + 生产版)
- 五、采集层怎么选:Filebeat、Elastic Agent 还是 Logstash
- 六、Logstash 管道三段式与 grok 实战
- 七、索引设计与 ILM 热温冷删
- 八、核心调优:分片、JVM、refresh 与批量写入
- 九、十个必踩的坑(重点)
- 十、查询与可视化:KQL、ES|QL 与 Dashboard
- 十一、排障对照表
- 十二、一页速查与生产建议
零、先搞清楚:ELK、Elastic Stack 与 OpenSearch 是什么关系
很多人一上来就被名字绕晕。先把三个名字捋直:
- ELK = Elasticsearch(存储与检索)+ Logstash(采集处理)+ Kibana(可视化),是这套技术栈最早的名字。
- Elastic Stack = ELK + Beats(后置为 Elastic Agent)+ APM 等组件,是 Elastic 官方现在使用的名字。日常说的「ELK」和「Elastic Stack」基本是同一个东西。
- OpenSearch = 2021 年 Elasticsearch 7.10 / Kibana 7.10 的社区分叉,由 OpenSearch 基金会(Linux 基金会旗下)维护,用 Apache 2.0 许可。API 看着眼熟,但版本、插件、许可早已各走各路。
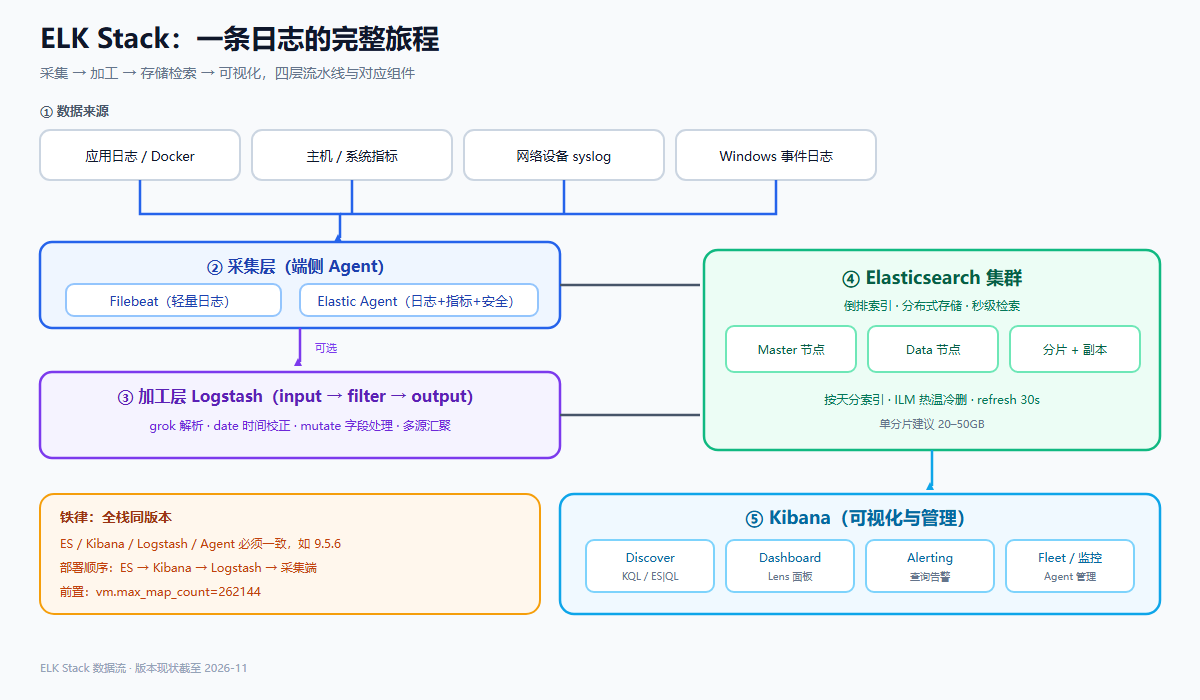
各组件的分工是一条流水线:
| 组件 | 角色 | 一句话 |
|---|---|---|
| Elasticsearch | 存储 + 检索 | 倒排索引,把日志存进去、秒级搜出来 |
| Logstash | 采集 + 加工 | input → filter → output,把脏日志洗成结构化字段 |
| Kibana | 可视化 + 管理 | 查数据、做面板、管集群、配 Fleet |
| Filebeat / Elastic Agent | 端侧采集 | 装在每台机器上,把日志送进 ES 或 Logstash |
什么时候不该上 ELK? 客观说清楚边界:
- 只是几台机器、日志量很小:上 ELK 是杀鸡用牛刀,一台机器的 JVM 内存就比你日志还多,考虑 Loki 或直接看文件。
- 团队没人愿意维护:ELK 不是装完就完,分片、ILM、升级都要有人盯,无人值守迟早变「日志黑洞」。
- 只要全文检索不要运维平台:那是用 Elasticsearch 本身,Kibana/Logstash 未必需要。
但对需要复杂字段检索、聚合分析、安全审计(SIEM)、中文分词的场景,ELK 至今仍是绕不开的选项——这也是它在 2026 年仍是 Fortune 500 一半公司在用的原因。
一、版本与许可:2026 年动手前必读
这一节决定你能不能装得上、装的是哪个许可的产品,务必先看。
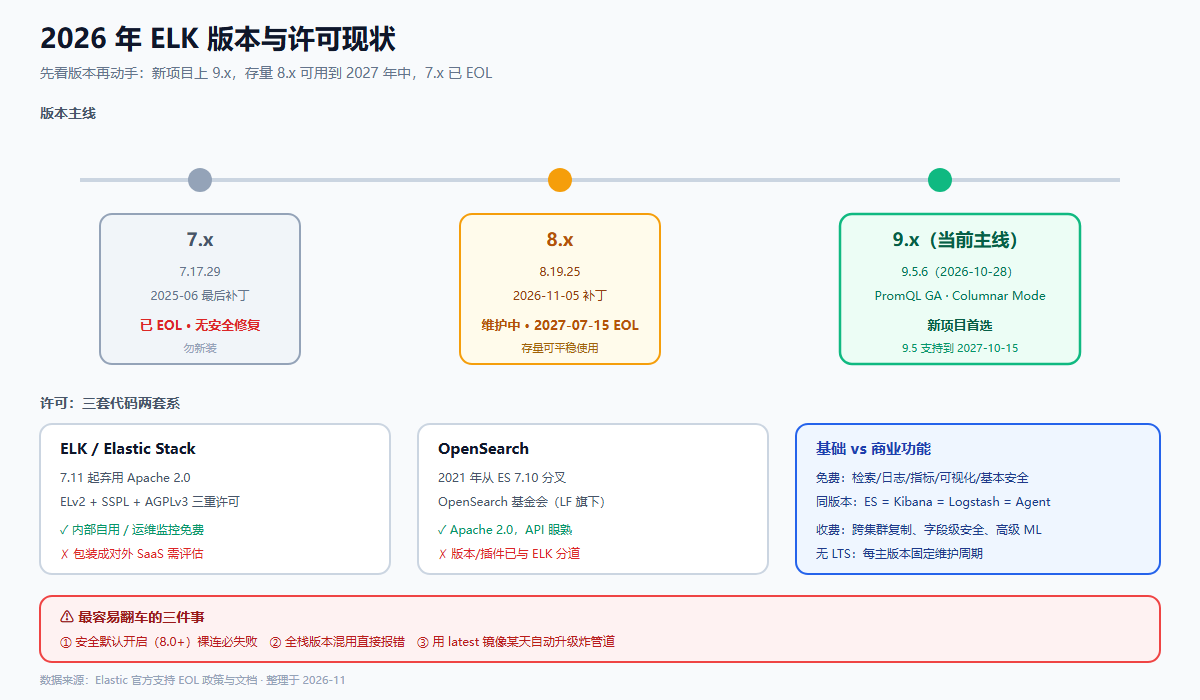
1.1 版本现状(截至 2026-11)
| 主版本 | 最新补丁 | 状态 |
|---|---|---|
| 9.x | 9.5.6(2026-10-28) | 当前主线,持续更新 |
| 8.x | 8.19.25(2026-11-05) | 仍在维护,2027-07-15 EOL |
| 7.x | 7.17.29(2025-06-18) | 已 EOL,不再有安全修复 |
| 6.x 及以下 | — | 早已 EOL |
结论:新项目直接上 9.x;存量 8.x 集群可以平稳用到 2027 年年中再规划升级;7.x 及以下赶紧走,别再新装。
注意:Elastic 没有 LTS 版本,每个主版本都按固定维护周期走。所谓「长期稳定版」的说法不适用于 ELK,别被误导。
1.2 一条铁律:全栈同版本
官方明确要求:Elasticsearch、Kibana、Logstash、Beats、APM Server 必须全部使用相同版本号。ES 9.5.6 就要配 Kibana 9.5.6、Logstash 9.5.6,混用会直接报错。Docker Compose 里最稳妥的做法是用一个变量统一版本:
1 | # .env |
1 | image: docker.elastic.co/elasticsearch/elasticsearch:${ELK_VERSION} |
1.3 许可:为什么会有 OpenSearch
Elasticsearch 7.11 之后不再使用 Apache 2.0,改为 Elastic License 2.0 + SSPL + AGPLv3 三重许可。核心差别:
- 基础功能免费:日志、指标、检索、可视化、基本安全都能用(Basic 订阅)。
- 商业功能收费:跨集群复制、细粒度字段/文档安全、机器学习高级功能等需要付费订阅。
- 不能拿它做成对外提供的搜索服务——SSPL/Elastic License 的限制点就在这里。如果你要做 SaaS 转售,这正是当年 AWS 与 Elastic 闹掰、进而分叉出 OpenSearch 的原因。
一句话:自用、内部运维监控完全没问题;想包装成服务对外卖,先读许可条文或改用 OpenSearch。
二、整体架构与数据流
一条日志从产生到能查,经过这些环节:
1 | 应用/系统 → Filebeat 或 Elastic Agent →(可选 Logstash 清洗)→ Elasticsearch 索引 → Kibana 查询/面板 |
四种典型组合:
| 组合 | 适用 | 说明 |
|---|---|---|
| Beats → ES | 日志格式规整、量小 | 最简,少一个组件 |
| Beats → Logstash → ES | 需要 grok 解析、多源汇聚 | 最经典,灵活但多一个 JVM |
| Elastic Agent → Fleet → ES | 新版主推 | 一个 Agent 收日志+指标+安全,Kibana 集中管策略 |
| Filebeat → Kafka → Logstash → ES | 高吞吐、要削峰 | 多一层消息队列,抗堆积 |
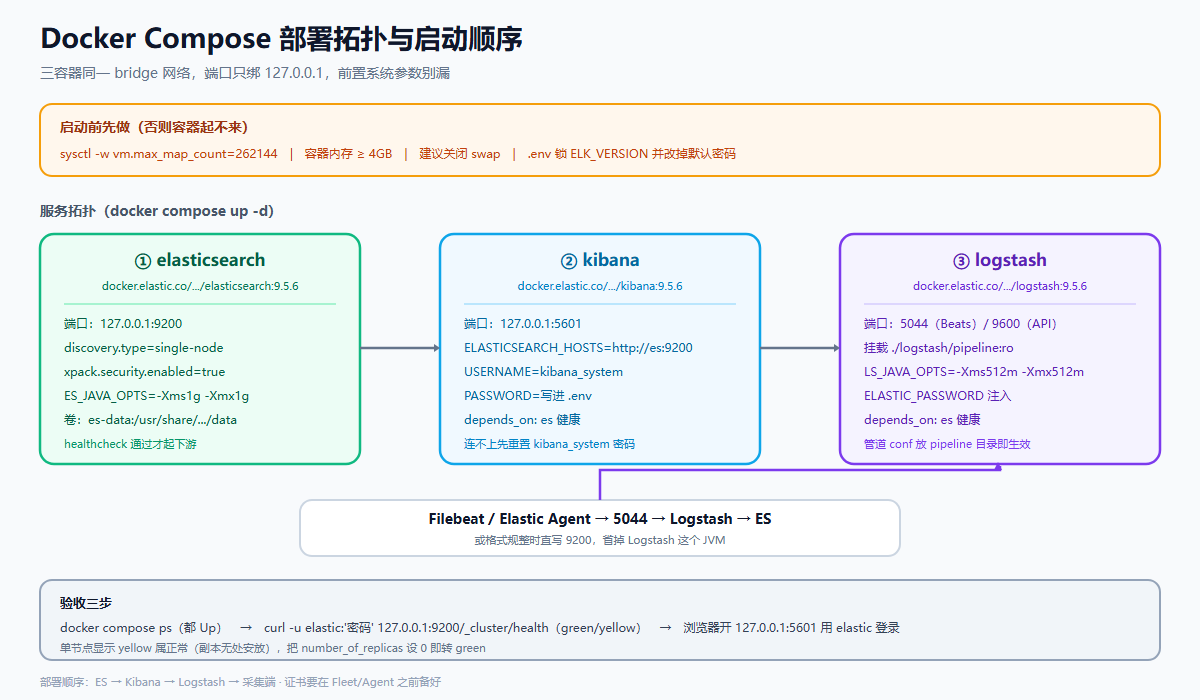
Docker Compose 单机拓扑:ES(9200)+ Kibana(5601)+ Logstash(5044/9600)三个容器挂同一个自定义网络,采集侧用 Filebeat 容器读宿主机日志目录。生产环境再把 ES 拆成 3 个 master 候选节点 + 若干 data 节点。
部署顺序有讲究:Elasticsearch → Kibana → Logstash → 采集端。后面的组件依赖前面的证书和令牌,先部署 Agent 会因拿不到 CA 证书而反复重装。
三、部署前的系统前置(这一步最容易被跳过)
Elasticsearch 对内核参数有硬性要求,容器化也一样。三项必须做:
3.1 vm.max_map_count
ES 使用 mmapfs 存储索引,Linux 默认 65530 太小,不调容器会直接退出:
1 | # 临时生效 |
核实:sysctl vm.max_map_count,输出应为 262144。
3.2 文件句柄与进程数
编辑 /etc/security/limits.conf:
1 | elasticsearch soft nofile 65535 |
容器部署时通常已在镜像内设好,宿主机重点还是 max_map_count 和内存。
3.3 内存与 swap
- Elasticsearch 是内存大户。单节点体验至少给容器分配 4GB 内存;生产 data 节点建议 16GB 起步,其中一半给 JVM heap(上限 31GB,超过反而浪费指针压缩)。
- 建议禁用 swap 或对 ES 进程设置
mlockall,避免 JVM 堆被换出导致 GC 停顿飙升。
1 | sudo swapoff -a # 临时关闭 |
四、Docker Compose 部署(体验版 + 生产版)
4.1 三分钟体验版
只想快速看一眼长什么样,官方提供了一条命令:
1 | curl -fsSL https://elastic.co/start-local | sh |
它会拉起单节点 ES + Kibana,脚本结束时会打印 elastic 用户的临时密码和 Kibana 地址(默认 http://localhost:5601)。只适合本地把玩,不要用于任何真实数据。
4.2 可上生产的 Compose 版
目录结构:
1 | elk/ |
.env(改掉默认密码,别提交到 Git):
1 | ELK_VERSION=9.5.6 |
docker-compose.yml:
1 | name: elk |
启动与验收:
1 | docker compose up -d |
Kibana 连不上的处理:9.x 启用了安全,Kibana 需要用 kibana_system 用户连 ES。先用 elastic 超级用户在 ES 上重置该用户密码,再把新密码写进 .env 的 KIBANA_PASSWORD:
1 | curl -u elastic:'你的密码' -X POST \ |
生产环境还应加上 TLS(ES 传输层与 HTTP 层)、xpack.security.enrollment.enabled 与 CA 证书挂载;证书要在部署 Fleet / Agent 之前准备好,否则换新证书后 Agent 得重装。
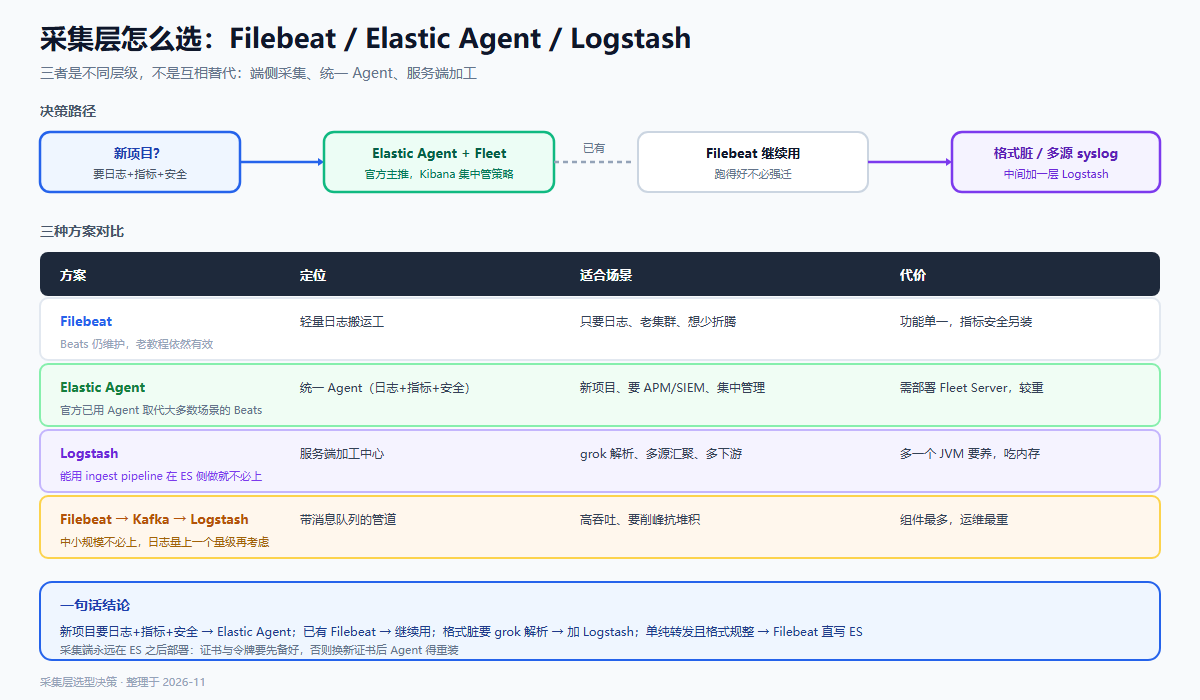
五、采集层怎么选:Filebeat、Elastic Agent 还是 Logstash
这是最容易被教程带偏的一节。三者不是替代关系,而是不同层级:
| 方案 | 定位 | 适合 |
|---|---|---|
| Filebeat | 轻量日志搬运工 | 只要日志、想少折腾、老集群 |
| Elastic Agent | 统一 Agent(日志+指标+安全) | 新版主推,Kibana Fleet 集中管策略 |
| Logstash | 服务端加工中心 | 多源汇聚、grok 解析、写到多个下游 |
官方现在的态度很明确:Beats 已被 Elastic Agent 取代,大多数新场景应优先用 Agent。但 Beats 依然可用、依然维护,老教程不必推倒重来。
决策建议:
- 新项目、要指标和安全:上 Elastic Agent + Fleet,一个 Agent 顶掉 Filebeat + Metricbeat + Auditbeat。
- 已有 Filebeat 跑得好好的:不必强迁,继续用。
- 日志格式脏、多设备 syslog、要解析成字段:在中间加一层 Logstash。
- 单纯转发、格式规整:Filebeat 直写 ES,省一个 JVM。
六、Logstash 管道三段式与 grok 实战
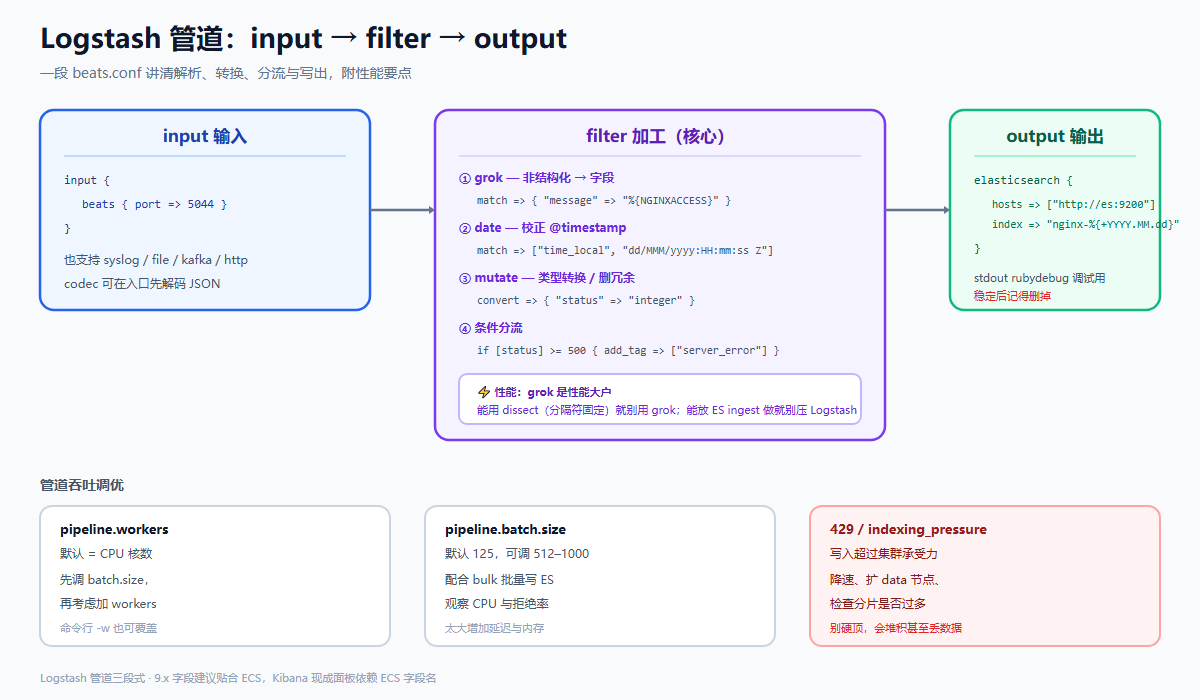
Logstash 配置就是三段:input → filter → output。
logstash/pipeline/beats.conf 一个可读的示例:
1 | input { |
几个务必记住的点:
- grok 是性能大户。能用
dissect(分隔符固定)就别用 grok;能用 ingest pipeline 在 ES 侧做,就别都压在 Logstash。 - 管道 workers 与批量大小:
pipeline.workers默认等于 CPU 核数,pipeline.batch.size默认 125。吞吐不够时先调大 batch size,再考虑加 workers。 - 加
stdout { codec => rubydebug }调试,确认字段解析对了再删,否则你会对着空面板怀疑人生。 - 9.x 起注意 ECS 兼容:字段尽量贴合 Elastic Common Schema,Kibana 的很多现成面板依赖 ECS 字段名。
七、索引设计与 ILM 热温冷删
日志索引如果不管,磁盘迟早被撑爆。两件事要解决:怎么分索引、什么时候删。
7.1 索引粒度
- 按天分索引(
nginx-2026.11.16)是日志场景的主流:便于按时间删除、生命周期管理清晰。 - 分片数别贪多。每个分片都是 Lucene 实例,吃文件句柄、吃内存。经验值:单个分片 20–50GB 为宜。每天 50GB 日志,1 个主分片 + 1 副本足够;每天 500GB 再考虑 10 个分片。
写入模板控制分片和映射:
1 | PUT _index_template/nginx-logs |
7.2 ILM 生命周期
ILM(Index Lifecycle Management)把索引分成四个阶段自动流转:
| 阶段 | 动作 | 典型配置 |
|---|---|---|
| Hot | 正在写入,可搜索 | 滚动:索引达 50GB 或 30 天 rollover |
| Warm | 不再写入,仍查询 | 强制段合并、副本数降为 1、迁移到温节点 |
| Cold | 极少查询 | 迁移到冷节点、缩分片 |
| Delete | 到期删除 | 保留 90 天后删除 |
在 Kibana → Stack Management → Index Lifecycle Policies 里点几点就能建,也能用 API:
1 | PUT _ilm/policy/logs-policy |
单节点玩不了热温冷分层(没有不同角色的节点),但 Hot + Delete 两阶段照样能用,先把「自动删除」这条最值钱的做起来。
八、核心调优:分片、JVM、refresh 与批量写入
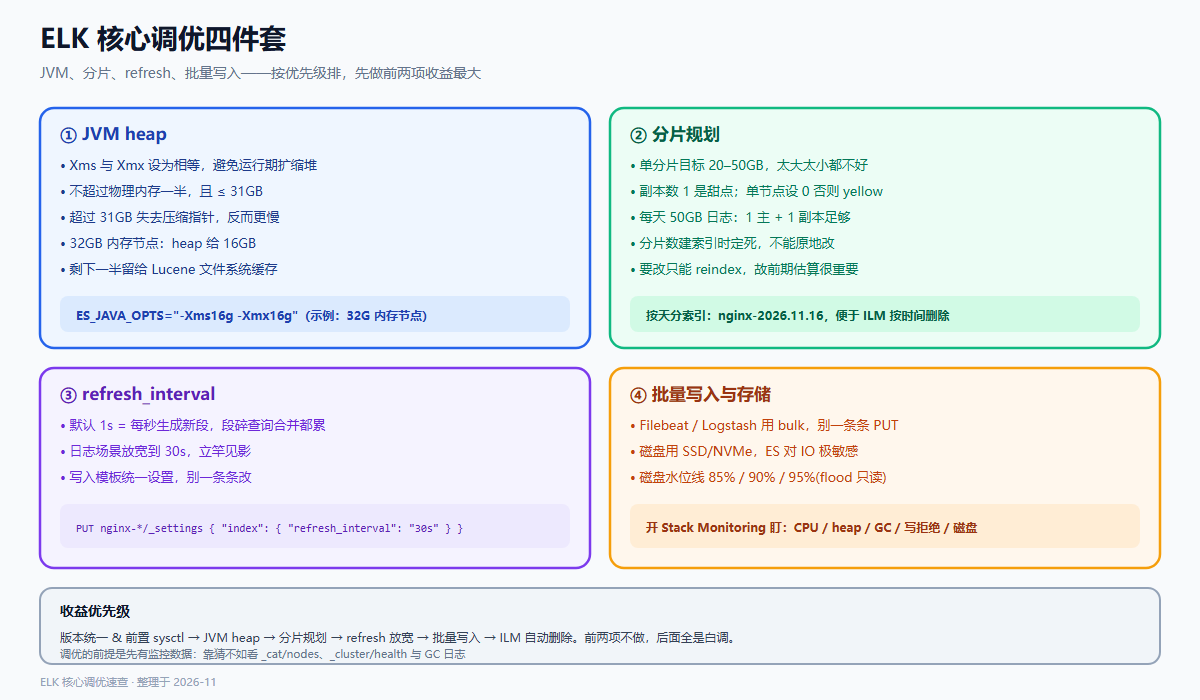
8.1 JVM heap
- 设置
-Xms与-Xmx相等,避免运行时动态扩缩堆。 - heap 不超过物理内存一半,且不超过 31GB(超过会失去压缩指针,反而变慢)。
- 生产 32GB 内存的 data 节点:heap 给 16GB,剩下一半留给 Lucene 文件系统缓存。
8.2 分片
- 目标:单分片 20–50GB。太小(大量小分片)比太大更伤集群。
- 副本数 1 是大多数场景的甜点;单节点设 0,否则一直 yellow。
- 分片数在建索引时定死,不能原地修改,要改得 reindex。
8.3 refresh_interval
默认 1 秒 refresh,意味着每秒生成新段,段多了查询和合并都累。日志场景对近实时要求没那么高,放宽到 30 秒立竿见影:
1 | PUT nginx-*/_settings { "index": { "refresh_interval": "30s" } } |
8.4 批量写入
- Filebeat / Logstash 用 bulk 批量写,别一条一条 PUT。
bulk.queue.size、pipeline.batch.size适当调大(如 512–1000),观察 CPU 和bulk拒绝率(indexing_pressure)。- 出现
429 / rejected execution说明写入超过集群承受力,要降速或扩容,别硬顶。
8.5 存储与监控
- 用 SSD,RAID 或 NVMe;ES 对磁盘 IO 极敏感。
- 磁盘水位线:
cluster.routing.allocation.disk.watermark.low=85%、high=90%、flood_stage=95%,到 flood 阶段索引会变只读。 - 开 Stack Monitoring 盯住:CPU、heap 使用率、GC 时间、索引延迟、磁盘水位。指标比直觉可靠。
九、十个必踩的坑(重点)
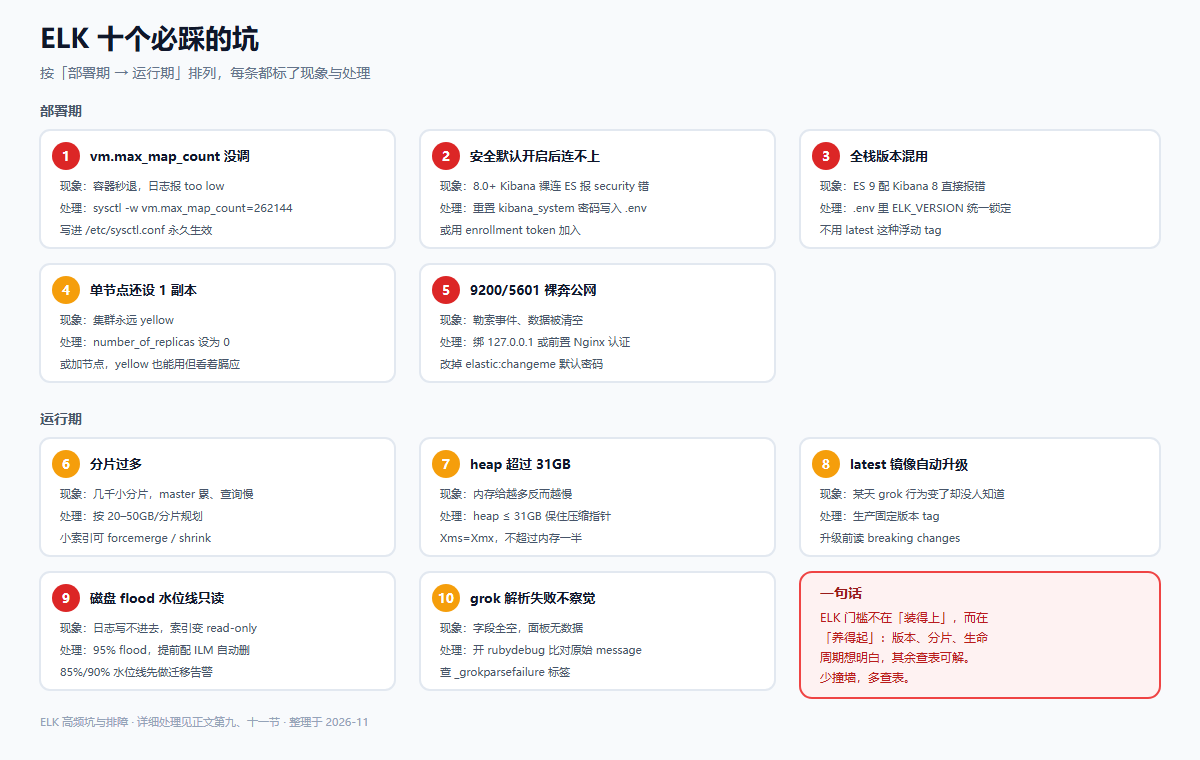
vm.max_map_count没调:容器反复重启,日志里max virtual memory areas vm.max_map_count is too low。装前先sysctl -w vm.max_map_count=262144。- 安全默认开启后 Kibana 连不上:8.0 起
xpack.security.enabled=true是默认,必须用kibana_system用户配密码,或走 enrollment token,老教程的http://es:9200裸连全失效。 - 全栈版本混用:ES 9 配 Kibana 8 直接报错。用
.env的ELK_VERSION统一锁定。 - 单节点还设 1 副本:集群永远 yellow,搜日志没问题但看着膈应。单节点把
number_of_replicas设为 0。 - 把 9200/5601 直接暴露公网:无数勒索事件就是这么来的。用
127.0.0.1绑定或前置 Nginx + 认证 + 防火墙放行。 - 默认密码不改:
elastic:changeme是所有人知道的密码,装完第一件事就是改。 - 分片过多:一个节点上几千个小分片,master 累死、查询也慢。按 20–50GB/分片规划。
- heap 超过 31GB:以为给越多越快,实际失去压缩指针后性能反降。
- Logstash 用
latest镜像:某天自动升级到新版,grok 插件行为变了却没人知道。生产固定版本 tag。 - 磁盘到 flood 水位线变只读:日志写不进去还查不出原因。提前配 ILM 自动删除 + 监控告警。
十、查询与可视化:KQL、ES|QL 与 Dashboard
数据进来了,怎么查?
- Discover + KQL:
status >= 500 and nginx.client_ip : "10.0.*",交互式排查最快。 - ES|QL:9.x 主推的管道式查询语言,
FROM logs-nginx-* | WHERE status >= 500 | STATS count() BY client_ip | SORT count() DESC,比老 DSL 好写太多。 - Dashboard:把常用查询固化成可视化面板,配 Lens 拖拽即可,别每次手写 DSL。
- 告警:Kibana Alerting 支持按查询结果触发(如 5 分钟内 500 错误 > 100),能推邮件、Webhook、钉钉/企业微信。
9.5 起 PromQL 已 GA:可以把 Prometheus 指标直接导进 Elasticsearch 并用 PromQL 查,Grafana 面板和工具能平滑迁移,还自带迁移工具。如果已经在用 Grafana,这条值得一试。
十一、排障对照表
| 现象 | 最可能原因 | 处理 |
|---|---|---|
| ES 容器秒退 | vm.max_map_count 太小 / 内存不足 |
调 sysctl;给足 4GB+ |
| 集群一直 yellow | 单节点副本无处分配 | 副本数设 0 或加节点 |
| Kibana 报 security 错误 | 没配 kibana_system 密码 / 令牌 |
重置该用户密码写入 .env |
| Logstash 收不到 Beats 数据 | 5044 未通 / 防火墙 | 查端口与容器网络,看 docker logs |
grok 解析出 _grokparsefailure |
pattern 不匹配 | 开 rubydebug 看原始 message,调表达式 |
| 磁盘写满、索引只读 | 到 flood 水位线 | 清数据 / 扩盘 / 配 ILM 删除 |
| 查询很慢 | 分片过多 / 段太碎 | 合并段、调 refresh、合并索引 |
| 升级后组件报错 | 版本不一致 | 全栈统一到同版本号 |
| heap 持续增长不降 | 缓存膨胀 / 查询太大 | 看 GC 日志,限制聚合基数 |
| 日志有但时间戳不对 | 时区/date filter 配错 | 检查 date 插件与 @timestamp |
十二、一页速查与生产建议
最小可用清单:
1 | sudo sysctl -w vm.max_map_count=262144 # ① 系统前置 |
生产环境的六条底线:
- 全栈同版本,固定 tag,不用
latest。 - 9200/5601 不裸奔,前置认证与网络隔离。
- 至少 3 个 master 候选节点,data 节点 SSD、内存 16GB 起。
- heap 设为内存一半且 ≤31GB,Xms=Xmx。
- 上线第一天就配 ILM 自动删除,别等磁盘爆。
- 开 Stack Monitoring + 告警,把「磁盘、heap、GC、写入拒绝」四条盯死。
ELK 的门槛从来不在「装得上」,而在「养得起」。把版本、分片、生命周期这三件事想明白,剩下的问题大多能查表解决。希望这篇能让你少撞几堵墙。