Keepalived + Nginx 双机热备实战:VIP 漂移、健康检查与云上适配
单机 Nginx 挂掉,整站就跟着挂。keepalived 用 VRRP 把一个虚拟 IP(VIP)在两台机器之间漂移,客户端始终只认这个 IP,DNS 不用改、配置不用下发。
这篇不写「一键部署」,按原理 → 配置 → 验证 → 排坑 → 云上适配走一遍,重点放在那些照着教程抄完却切不过去的地方。
一、先别急着装:keepalived 到底解决什么
很多人把它叫「Nginx 集群」,其实不准确。keepalived 既不分发请求,也不做会话同步,它只做一件事:保证入口 IP 始终活着。
三个模块里,本篇只用两个:
| 模块 | 作用 | 本文是否用 |
|---|---|---|
| VRRP | 主备选举、VIP 漂移、心跳通告 | 用,核心 |
| Health Checker | 通过脚本把服务状态折算成优先级 | 用,关键 |
| IPVS / LVS | 四层负载均衡 | 不用,负载均衡交给 Nginx upstream |
所以完整的链路是:客户端 → VIP → 当前持 VIP 的那台 Nginx → upstream 后端。keepalived 只负责第一跳,后端应用的高可用靠 Nginx 自己的 upstream + 健康检查,两层要分开看,别指望一个 VIP 解决所有单点。
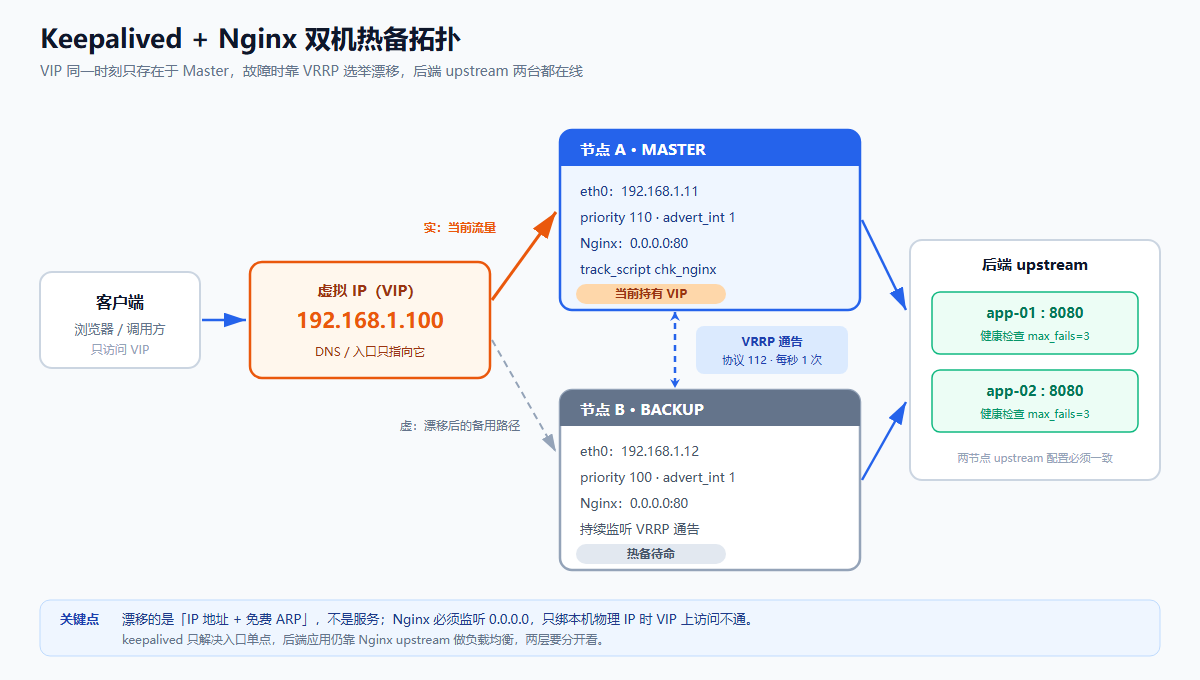
图里有三个容易忽略的点:
- VIP 同一时刻只应该出现在一台机器上。两台都出现,就是脑裂。
- 漂移的是地址,不是服务。切过去之后,新主上的 Nginx 必须本来就好好跑着。
- Nginx 必须监听
0.0.0.0。如果只写了listen 192.168.1.11:80,VIP 加进来也访问不通——这是「VIP 在、ping 通、curl 不通」的头号原因。
二、一次 VIP 漂移的完整过程
真正需要理解的是「机器没死、只是 Nginx 挂了」这种情况,它比整机宕机常见得多,而且光靠 VRRP 心跳是发现不了的。
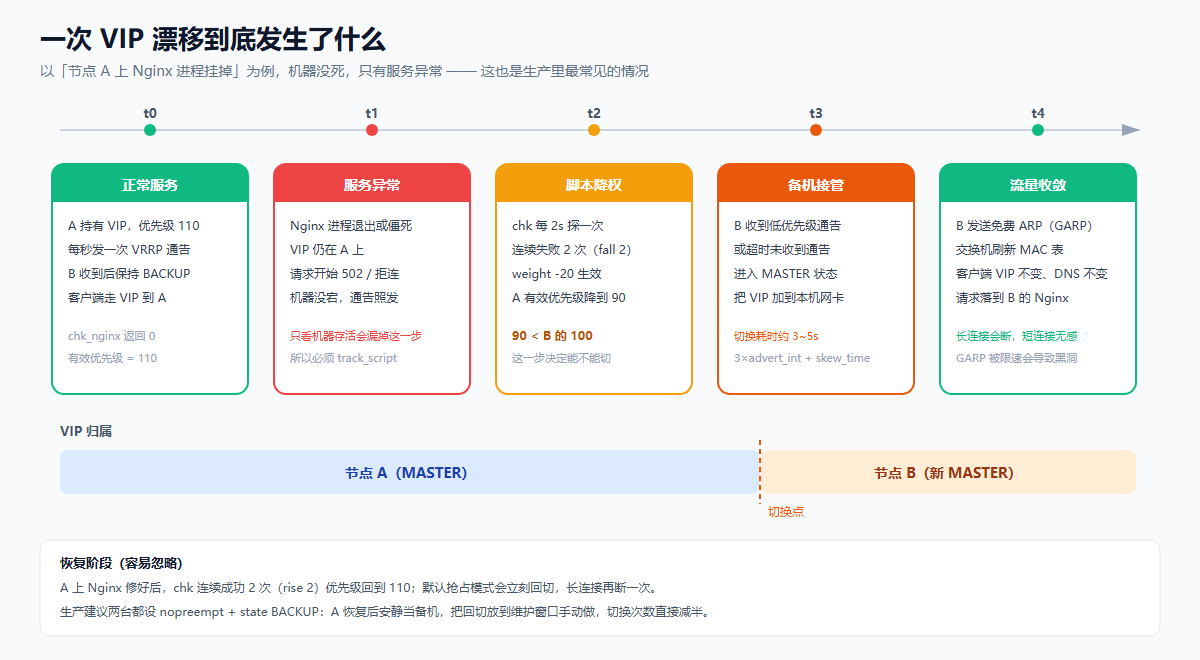
- 机器级故障:整台宕机 / 断网 / 防火墙拦了协议 112,备机收不到通告,等
3 × advert_int + skew_time后接管,约 3 秒多。这条路径 keepalived 自带,不用写脚本。 - 服务级故障:进程在、心跳照发,但 80 端口已经返回 502。必须靠
track_script主动降优先级,让备机的优先级反超,才会触发选举。
skew_time = (256 - priority) / 256 秒,用来让高优先级节点更快抢占、避免同时宣告。切换窗口里长连接会断、短连接基本无感,所以「零丢包」是不现实的承诺,验收时看的是丢包个数和收敛时长。
恢复阶段更坑:默认抢占模式下,主节点修好会立刻把 VIP 抢回来,长连接再断一次。生产上建议两台都开 nopreempt,把回切放到维护窗口手动做,切换次数直接减半。
三、环境约定与前置检查
以两台 Ubuntu 24.04、同网段为例(实际 IP 和网卡名按你的机器替换):
| 项 | 节点 A(主) | 节点 B(备) |
|---|---|---|
| 物理 IP | 192.168.1.11 | 192.168.1.12 |
| 网卡 | ens160 | ens160 |
| 优先级 | 110 | 100 |
| initial state | BACKUP | BACKUP |
| VIP | 192.168.1.100/24 | 同一个 |
先确认网卡名,别想当然写 eth0:
1 | ip -br link |
安装依赖:
1 | sudo apt update |
psmisc提供killall,iputils-arping用来验免费 ARP,tcpdump抓 VRRP 报文。- 两台机器时间要对齐(
timedatectl/ chrony),否则排障时日志对不上。 - VIP 不要写进 netplan、不要静态配到网卡上,交给 keepalived 增删,两边抢一个静态地址会打成硬故障。
四、Nginx 层:两台配置必须完全一致
先在两台都配好同样的 upstream 和健康探测端点。/etc/nginx/conf.d/site.conf 示例:
1 | upstream app_pool { |
1 | sudo nginx -t |
两台都验完再往下走。备机不是「等切过去再装服务」,它必须随时能接住流量,这是双机热备和冷备的区别。
五、健康检查脚本与优先级账本
/etc/keepalived/chk_nginx.sh:
1 |
|
1 | sudo chmod 700 /etc/keepalived/chk_nginx.sh |
只查进程(pgrep nginx)会漏掉「进程在但端口堵死、upstream 全挂」的情况,所以探 HTTP 端点更实在;如果 Nginx 后面还挂着别的关键依赖,可以在脚本里再加一层判断。
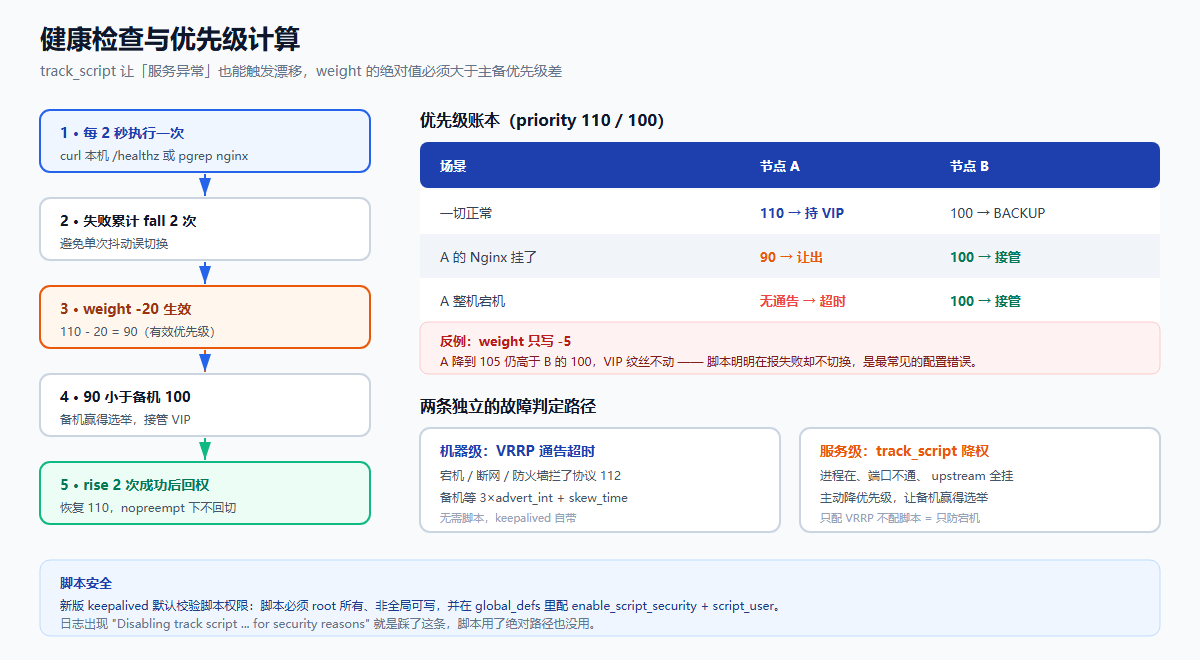
优先级账本要自己算一遍:
| 场景 | 节点 A 有效优先级 | 节点 B | 结果 |
|---|---|---|---|
| 正常 | 110 | 100 | A 持 VIP |
| A 的 Nginx 挂了(weight -20) | 90 | 100 | B 接管 |
| A 整机宕机 | 无通告 | 100 | B 超时接管 |
最常见的配置错误就是 weight 写小了。主备差 10,你写 weight -5,A 降到 105 仍然赢,日志里明明在报脚本失败,VIP 却纹丝不动。经验值:|weight| > 主备优先级差,再留一点余量,这里用 -20。
补充两个判定路径之外的细节:
fall 2/rise 2:连续失败 2 次才判死、连续成功 2 次才恢复,用来吃掉瞬时抖动;interval 2表示每 2 秒探一次,所以服务异常到开始降权大约 4 秒。enable_script_security:新版 keepalived 会校验脚本权限,脚本必须 root 所有、组和其他用户不可写、路径目录也不能被普通用户写。日志里出现Disabling track script ... for security reasons就是踩了这条,光把命令改成绝对路径没用。
六、keepalived.conf 完整配置
下面这份是单播版,机房和云上都能用;组播版的差异在文末说。
节点 A:/etc/keepalived/keepalived.conf
1 | global_defs { |
节点 B 只改四处,其余逐字保持一致:
1 | router_id nginx_b |
state、 nopreempt、virtual_router_id、advert_int、track_script、virtual_ipaddress 两边必须一样。
状态通知脚本 /etc/keepalived/notify.sh(同样 700 + root 所有):
1 |
|
几个配置的「为什么」:
- 两台都写
state BACKUP+nopreempt:nopreempt在初始 state 为 MASTER 的节点上会被忽略。首次启动时仍由优先级选出主,之后主恢复了也不回抢。 - 不要开
vrrp_strict:strict 会按 RFC 严格模式禁掉单播 peers、认证和preempt_delay,还要求state MASTER时 priority 必须是 255。想用单播就别开它。 virtual_router_id同网段必须唯一(0–255)。同一广播域里另有一组 VRRP 用了 51,两边会互相干扰,表现为状态反复横跳。tcpdump -ni ens160 'ip proto 112'能看到所有发言者。- 认证那段没写:
auth_type PASS是明文 8 字符,只能防误接,不能防窃听。真要隔离请用独立 VLAN / 安全组,别把auth_pass当安全手段。 - 两份配置建议进 Git 或 Ansible,主备配置漂移是后期最难查的故障源。
七、防火墙:VRRP 不是端口,是 IP 协议 112
这是被拦得最多的一步。VRRP 既不是 TCP 也不是 UDP,ufw allow 80 之类完全不管用。
1 | # ufw(两台互相放通对端) |
组播版还要额外放 224.0.0.18;单播版不需要。云上除了系统防火墙,安全组也得放通 IP 协议 112(部分控制台的协议下拉里没有 112,需要用 API 或提工单配置,别漏了这层)。
内核参数方面,我们让 Nginx 监听 0.0.0.0,所以不需要 net.ipv4.ip_nonlocal_bind=1。只有当某个服务要明确 bind 到尚未落在本机的 VIP 时才需要它——顺便说一句,真有这种服务,主备切换时它能不能起来的问题比这个参数麻烦得多,尽量别设计成这样。
八、启动、验证与故障演练
启动前先做语法检查,能省掉一大半排障时间:
1 | sudo keepalived -t -f /etc/keepalived/keepalived.conf; echo "exit=$?" |
静态检查:
1 | ip addr show dev ens160 | grep 192.168.1.100 # 只应该在主节点出现 |
故障演练(从第三台客户端先起一个持续探测,边打边切):
1 | ping -i 0.2 192.168.1.100 |
依次在主节点上执行,每种都观察 VIP 归属和 journalctl:
| 演练动作 | 期望看到的日志 | 期望结果 |
|---|---|---|
systemctl stop nginx |
VRRP_Script(chk_nginx) failed |
约 4 秒后 B 接管,业务恢复 |
systemctl stop keepalived |
B 侧 Entering MASTER STATE |
约 3 秒后接管 |
reboot |
同整机失联 | 接管,重启后不回切 |
| 恢复 nginx / 重启 keepalived | VRRP_Script(chk_nginx) succeeded |
A 保持 BACKUP(nopreempt) |
验收记四个数:切换耗时、丢包个数、VIP 是否唯一、恢复后是否没回切。只测过一次的备机不叫备机,叫希望,配置每次变更后都要重测。
九、排坑对照表
| 现象 | 大概率原因 | 处理 |
|---|---|---|
| 两台都是 MASTER,各持 VIP | 心跳不通(协议 112 被拦 / 云上组播不通)、VRID 或认证不一致、两台不同子网 | 抓 ip proto 112;改单播;核对 VRID;放防火墙 |
| 脚本报失败但不切换 | weight 绝对值小于主备优先级差;脚本被 enable_script_security 拦掉 |
改 -20;chown root:root + chmod 700,目录也要检查 |
| VIP 在、能 ping、curl 超时 | Nginx 只绑了物理 IP;后端 upstream 挂了;GARP 被交换机限速 | 改 listen 0.0.0.0:80;从备机直连 upstream;arping 验 MAC |
| 切换后客户端卡几十秒 | 上游交换机 / 客户端 ARP 缓存没刷新 | 检查 GARP、交换机 ARP/CAM 老化时间;云上改用 HaVip |
| 状态几秒一次来回抖 | 健康检查在临界值(服务反复重启)、同网段 VRID 撞车 | 加大 fall/rise,修服务本身;抓包看有没有第三方在发言 |
| 主恢复后立刻又切回来 | 默认抢占 | 两台都加 nopreempt + state BACKUP |
日志 Disabling track script for security reasons |
脚本或父目录对非 root 可写 | 收紧权限,配 script_user |
| VIP 死活加不上 | VIP 已被 netplan 静态占用、网段写错、网卡名写错 | 清掉静态配置,核对 ip -br addr |
十、脑裂:成因与能做的防护
心跳断了的那一刻,备机无法区分「主机死了」还是「只是我们之间断了」,于是两台都认为该自己当主 —— 这就是脑裂。两台都持 VIP 时,同网段会出现 IP 冲突,流量随机落到其中一台,比干脆全挂更难查。
能做的不是「消灭」脑裂(分布式系统里做不到),而是降低概率 + 快速发现:
- 心跳通道冗余:单播配置里加第二条链路(独立网卡 / 独立交换机),
unicast_peer可写多个对端地址。 - 第三方仲裁:脚本里除了探本机 Nginx,再 ping 一个稳定的网关 / 内网地址;探测不到就降权,让「孤岛节点」主动放弃 VIP。
nopreempt:减少不必要的切换次数,也就减少了在链路不稳时来回抢的机会。- 外部监控:从第三台机器定时查 VIP 的 MAC 归属,或从负载均衡侧看是否出现两个后端同时宣告;两台同时持 VIP 必须能告警。
- 业务层兜底:有状态服务别把 VIP 高可用当数据一致性保证,写冲突、会话丢失要在应用层解决。
一个简易仲裁脚本思路(接在 track_script 里,权重另算):
1 |
|
十一、阿里云 ECS 上的正确姿势:HaVip + 单播
机房里那套默认组播(224.0.0.18)在 VPC 里是不通的 —— 阿里云 VPC 不支持广播和组播。照搬过去,两台互相收不到通告,必然双主。
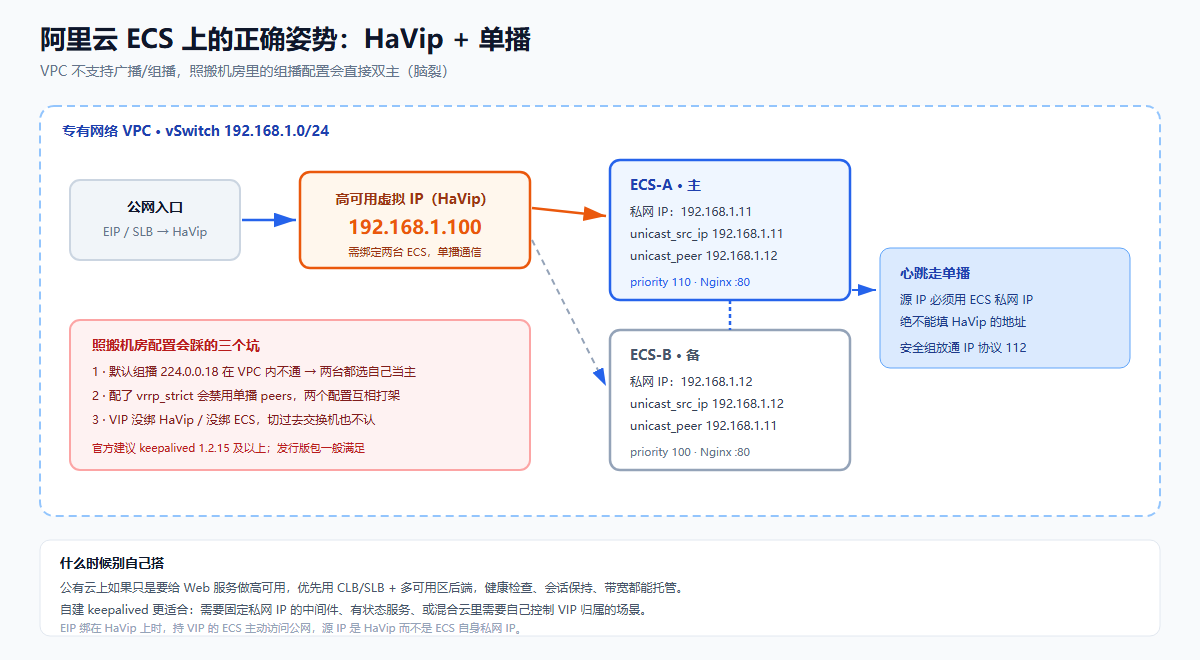
落地顺序:
- VPC 控制台创建高可用虚拟 IP(HaVip),地址选交换机网段里未占用的,例如 192.168.1.100;把它绑定到两台 ECS;需要公网入口时把 EIP 绑到 HaVip 上。
- 配置用上面的单播版:
unicast_src_ip填本机 ECS 私网 IP,unicast_peer填对端私网 IP。绝对不能把心跳源写成 HaVip 的地址。 - 不要开
vrrp_strict(它会禁掉unicast_peer)。 - 安全组 + 系统防火墙都放通 IP 协议 112;官方建议 keepalived 1.2.15 及以上,发行版包一般满足。
- 切完验一次
arping,确认 VIP 的 MAC 已经指向新主。
几个云上特有的注意点:
- EIP 绑在 HaVip 上时,持有 VIP 的 ECS 主动访问公网,源 IP 是 HaVip 的私网 IP,不是 ECS 自己的私网 IP;做白名单和出方向审计时要按这个来。
- 单播只解决了「选举能通」,VIP 本身能不能被路由,取决于 HaVip 是否正确绑定;
vrrp_strict容易让人在这两步之间反复怀疑人生。 - 如果只是给 Web 服务做高可用,优先用 CLB / SLB + 多可用区后端:健康检查、会话保持、带宽、证书都能托管,比自己维护 VRRP 省心。自建 keepalived 更适合需要固定私网 IP 的中间件、有状态服务,或混合云里必须自己控制 VIP 归属的场景。
如果是纯机房 / 虚拟化平台:删掉
unicast_src_ip和unicast_peer两段就是组播版,防火墙改为放通224.0.0.18与协议 112;同网段 VRID 保持唯一即可。
十二、上线检查清单
- [ ] 两台 Nginx 配置一致,都监听
0.0.0.0:80,/healthz都是 200 - [ ] upstream 后端两台都能直连,健康检查参数配好
- [ ] 脚本 700 + root 所有,
global_defs里enable_script_security/script_user到位 - [ ]
|weight|大于主备优先级差,fall/rise不为 1 - [ ] 两台
state BACKUP+nopreempt,只有priority/router_id/unicast_*不同 - [ ]
virtual_router_id在同网段唯一,网卡名用ip -br link核对过 - [ ] 协议 112 在系统防火墙和安全组两层都放通
- [ ] VIP 没被 netplan 静态占用,DNS / 上游只指向 VIP
- [ ] 四种故障演练全部做过,记录切换耗时与丢包数
- [ ] 有「两台同时持 VIP」的告警,配置进版本管理
小结:keepalived 的方案不复杂,难的全在细节里 —— 服务要监听 0.0.0.0、降权幅度要算够、VRRP 走的是协议 112、云上必须单播 + HaVip、恢复后别让它自动回切。把第二章的时序和第五章的优先级账本记住,剩下的排障基本就是对照第九章的表逐条排除。
本文配置基于 Ubuntu 24.04 + keepalived 2.x,不同发行版包名和脚本安全策略略有差异,上线前以
keepalived -v和keepalived -t的实际输出为准。


